모델 브리핑 — 2026-10-07 (수, KST 아침)
10월 7일 아침 브리핑으로 전달된 신규 모델 소식 요약 아카이브입니다. 성능 수치는 대부분 회사 자체 발표 이며 독립 검증 전입니다.
1. Mistral Large 4 “Le Chonk” — 1조(1.05T) 파라미터 오픈웨이트 멀티모달, 프리뷰 공개
- 원문: https://mistral.ai/news/mistral-large-4/
- 분야: 모델 · 오픈웨이트 LLM
- 날짜: 2026-10-06
미디어

출처: 원문 페이지 (Mistral AI) — 원본 이미지 링크(복제 저장 아님)
요약
프랑스 Mistral AI가 최대·최강 모델 Mistral Large 4(ML4, 별명 “Le Chonk”) 의 공개 프리뷰를 내놨습니다. 총 약 1조 파라미터(문서상 1.05T) 중 토큰당 490억(49B, 임베딩·출력층 포함 52B) 만 쓰는 세분화된 MoE(Mixture of Experts, 여러 전문가 하위망 중 일부만 골라 계산하는 구조) 이고, 1.6B 비전 인코더(vision encoder, 이미지를 모델이 이해하는 숫자로 바꾸는 부분) 를 갖춘 네이티브 멀티모달(natively multimodal, 처음부터 텍스트·이미지를 함께 학습) 모델입니다. 컨텍스트는 100만 토큰입니다.
지금은 Mistral Studio의 프리뷰 API로만 쓸 수 있고(문서 기준 입력 100만 토큰당 $0.68, 출력 $2.09 할인가 표기), 가중치는 이달 말 공개 예정입니다(로이터·TNW는 10월 27일, Hugging Face 페이지는 10월 31일로 표기). 그 전까지는 보안 기업·검증 파트너·국가 기관과 함께 완화된 제한으로 실전 레드팀(red-teaming, 일부러 공격해 약점을 찾는 시험) 을 진행합니다.
Mistral은 미국·유럽에서 만든 어떤 오픈웨이트 모델보다 크게 앞서고, 사이버보안·금융·법률 업무에선 오픈 모델 중 최고 수준이며, 비주얼 그라운딩(visual grounding, 이미지 속 특정 대상 위치를 찾아내는 능력) 은 일부 폐쇄형 프런티어 모델도 넘는다고 주장합니다(회사 발표 기준). 다만 코딩은 다른 프런티어 모델에 뒤진다고 인정했습니다. 학습은 유럽 자체 데이터센터의 NVIDIA Grace Blackwell GPU 3,800장(블로그 기준)으로 처음부터 진행했고, 9월 마감한 30억 유로 시리즈 D의 첫 결과물입니다. 로이터는 반도체 설계 능력과 삼성·ASML과의 반도체 밸류체인 협력 의지도 전했습니다.
시사점: 하루 전 Reflection의 Beam(501B)에 이어 “중국 오픈 모델의 서구권 대안” 경쟁이 1조 파라미터급으로 올라갔습니다. 가중치 공개 후 독립 벤치마크가 관건입니다.
2. Google DeepMind EmbeddingGemma 2 — 740M 멀티모달 임베딩 모델 (Apache 2.0)
- 원문: https://blog.google/innovation-and-ai/technology/developers-tools/embeddinggemma-2/
- 분야: 모델 · 임베딩/온디바이스
- 날짜: 2026-10-06
미디어

출처: 원문 페이지 (Google Blog) — 원본 이미지 링크(복제 저장 아님)
요약
구글이 EmbeddingGemma 2 를 공개했습니다. 임베딩 모델(embedding model, 글·이미지 등을 의미가 담긴 숫자 벡터로 바꿔 검색·분류에 쓰게 해주는 모델) 로, 텍스트·코드·이미지·영상·오디오를 하나의 768차원 공유 벡터 공간 에 매핑합니다. 예컨대 음성 메모로 특정 영상 클립을 찾거나, 텍스트 질의로 몇 시간 분량 녹음을 검색할 수 있습니다. Gemma 4 아키텍처 기반, 상업 이용 가능한 Apache 2.0 라이선스입니다.
구조가 모듈형이라 필요한 부분만 올릴 수 있습니다: 텍스트·코드 백본 270M + 비전 인코더 170M(선택) + 오디오 인코더 300M(선택) → 텍스트 전용 270M부터 전체 740M까지. 모든 구성이 같은 벡터 공간을 공유합니다. 컨텍스트는 8,192토큰(1세대의 4배)이고, MRL(Matryoshka Representation Learning, 벡터를 앞부분만 잘라 써도 품질이 유지되게 학습하는 기법) 로 512/256/128차원까지 줄여 저장 공간을 최대 6배 아낄 수 있습니다.
구글 발표 기준 다국어 텍스트 성능은 1세대 수준을 유지하면서 코드 성능(MTEB Code)이 68.76 → 78.68로 9.92점 올랐고, 1B 미만 모델 중 파라미터 대비 품질 최고 수준이라고 합니다. 1세대는 2,000만 회 넘게 다운로드됐습니다. Hugging Face·Kaggle 가중치와 함께 Ollama·llama.cpp(GGUF)·LiteRT 빌드가 첫날부터 제공됩니다.
시사점: 개인정보를 기기 밖으로 보내지 않는 온디바이스 RAG(검색 증강 생성) 와 코딩 에이전트의 코드베이스 검색에 바로 쓸 수 있는 경량 선택지입니다.
3. Cantina apex-flash-1 — 보안 취약점 연구 특화 오픈웨이트(321B, MIT)
- 원문: https://www.marktechpost.com/2026/10/04/can-an-open-model-do-security-research-cantinas-apex-flash-1-solves-40-of-60-held-out-bug-tasks/
- 분야: 모델 · 보안 특화
- 날짜: 2026-10-04
미디어
출처: 원문 페이지 (MarkTechPost) — 원본 이미지 링크(복제 저장 아님)
요약
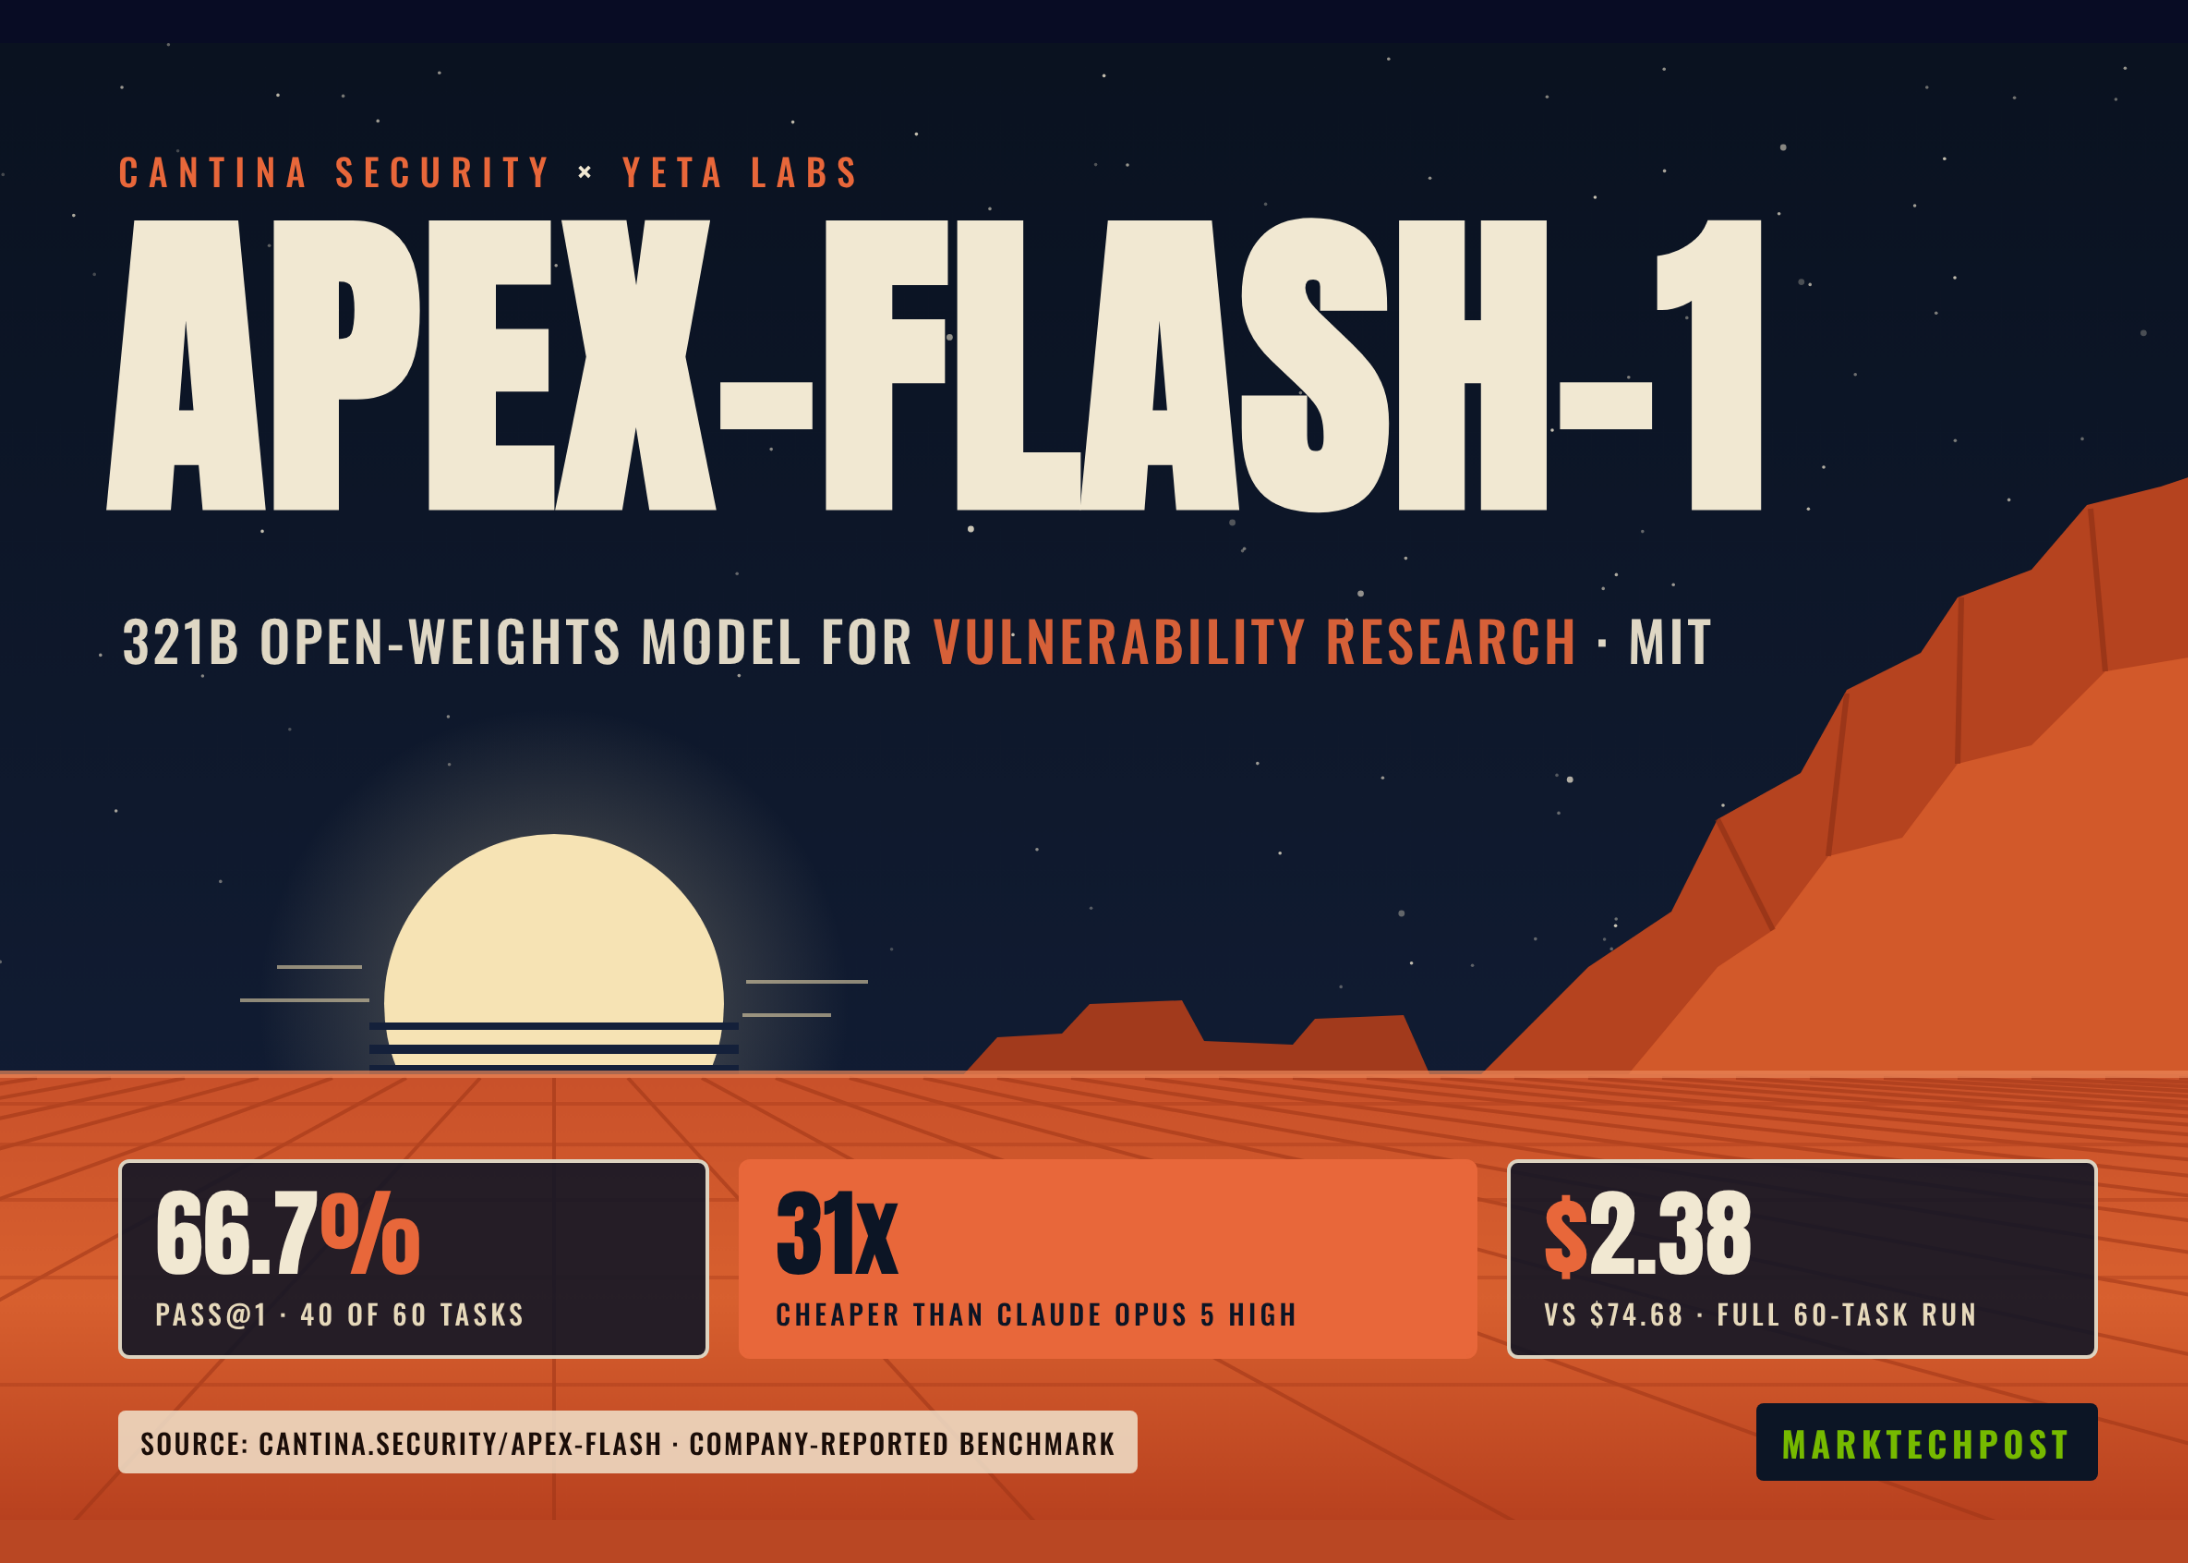
보안 기업 Cantina Security 가 Yeta Labs와 함께 취약점 연구(vulnerability research) 전용 오픈웨이트 모델 apex-flash-1 을 MIT 라이선스로 Hugging Face에 공개했습니다. Z.ai의 GLM-5.3-Flash(활성 18B MoE)를 강화학습(RL) 으로 미세조정한 모델로, 총 파라미터는 321.3B입니다. 학습엔 GRPO(그룹 단위로 답안을 비교해 보상을 주는 RL 기법) 와 rank-256 LoRA(일부 가중치만 저비용으로 덧대어 학습하는 기법) 를 썼고, 실제 취약점 사례 50건으로 만든 과제 150개를 Codex 에이전트 환경에서 돌렸습니다. 사례의 72%가 인가·신원·권한 범위 결함입니다.
학습에 쓰지 않은 20개 사례(60개 과제) 평가에서 apex-flash-1은 40/60(66.7%) 을 풀어 기반 모델(36/60)을 앞섰고, Claude Opus 5 High(43/60)에 근접했습니다. 비용은 회당 약 $2.38 vs Opus $74.68로 약 31배 차이라고 합니다(회사 자체 벤치마크 기준).
Cantina는 이 모델을 혼자 다 하는 모델이 아니라, 큰 모델이 지휘하는 에이전트 아래에서 코드 읽기·도구 사용·익스플로잇 작성·검증을 맡는 워커(worker) 모델 로 규정합니다. vLLM·SGLang·Transformers로 서빙 가능하지만 BF16 기준 GPU 메모리가 약 640GB 필요합니다.
시사점: 같은 날 Anthropic·Mistral이 사이버 능력 접근을 통제·완화하는 정책을 내놓은 가운데, 오픈 진영에선 저비용 보안 특화 모델이 나오고 있습니다.
4. Google Nano Banana 2.1, 구글 검색 AI 모드에 탑재
- 원문: https://www.seroundtable.com/nano-banana-21-google-ai-mode-42246.html
- 분야: 모델 · 이미지 생성/편집
- 날짜: 2026-10-06
미디어
출처: 원문 페이지 (Search Engine Roundtable) — 원본 이미지 링크(복제 저장 아님)
요약
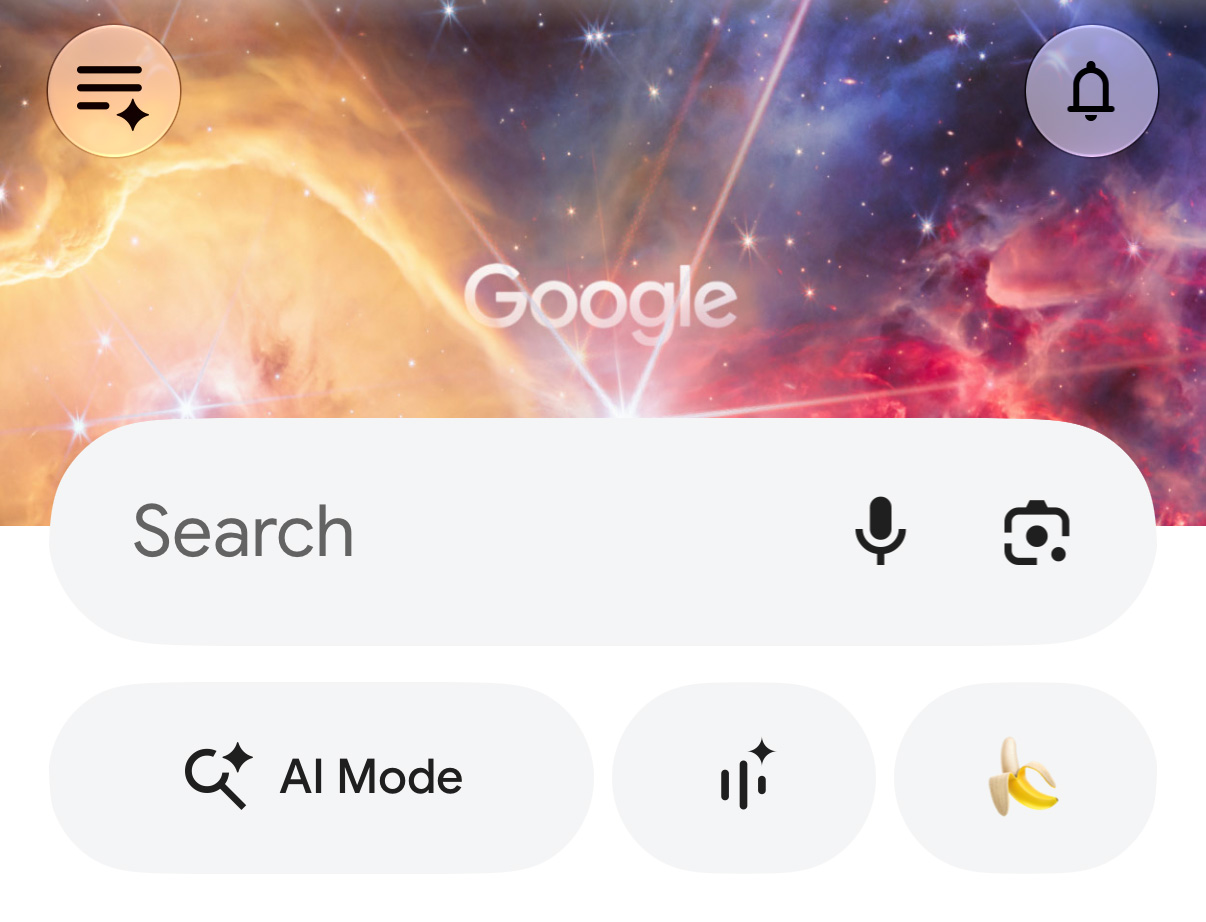
구글의 이미지 생성·편집 모델 Nano Banana 2.1 이 구글 검색 AI 모드(AI Mode) 에 배포되기 시작했습니다. 구글 앱 검색창 아래 바나나 아이콘을 눌러 이미지를 만들거나 편집할 수 있습니다.
개선점으로는 시각 품질 향상, 마스크 편집(mask editing, 이미지의 지정한 영역만 골라 수정), 같은 인물·사물을 여러 장에서 일관되게 유지하는 능력, 이미지 속 글자 렌더링 개선이 꼽히며, 참조 이미지를 최대 14장까지 넣을 수 있습니다. Gemini API 문서와 DeepMind 모델 카드도 함께 공개돼 있습니다.
시사점: 생성형 이미지 기능이 별도 앱이 아니라 검색 같은 대중 서비스 안으로 들어가는 흐름이 계속되고 있습니다.