엔진 브리핑 — 2026-10-07 (수, KST 아침)
10월 7일 아침 브리핑으로 전달된 LLM 추론·서빙 엔진(런타임) 소식 요약 아카이브입니다. 릴리스 내용은 GitHub 릴리스 노트·원문 기준입니다.
1. EmbeddingGemma 2, 첫날부터 Ollama·llama.cpp·vLLM·SGLang 등에서 실행 가능
- 원문: https://ollama.com/library/embeddinggemma-2:740m
- 분야: 엔진 · 모델 지원(day-0)
- 날짜: 2026-10-06
미디어
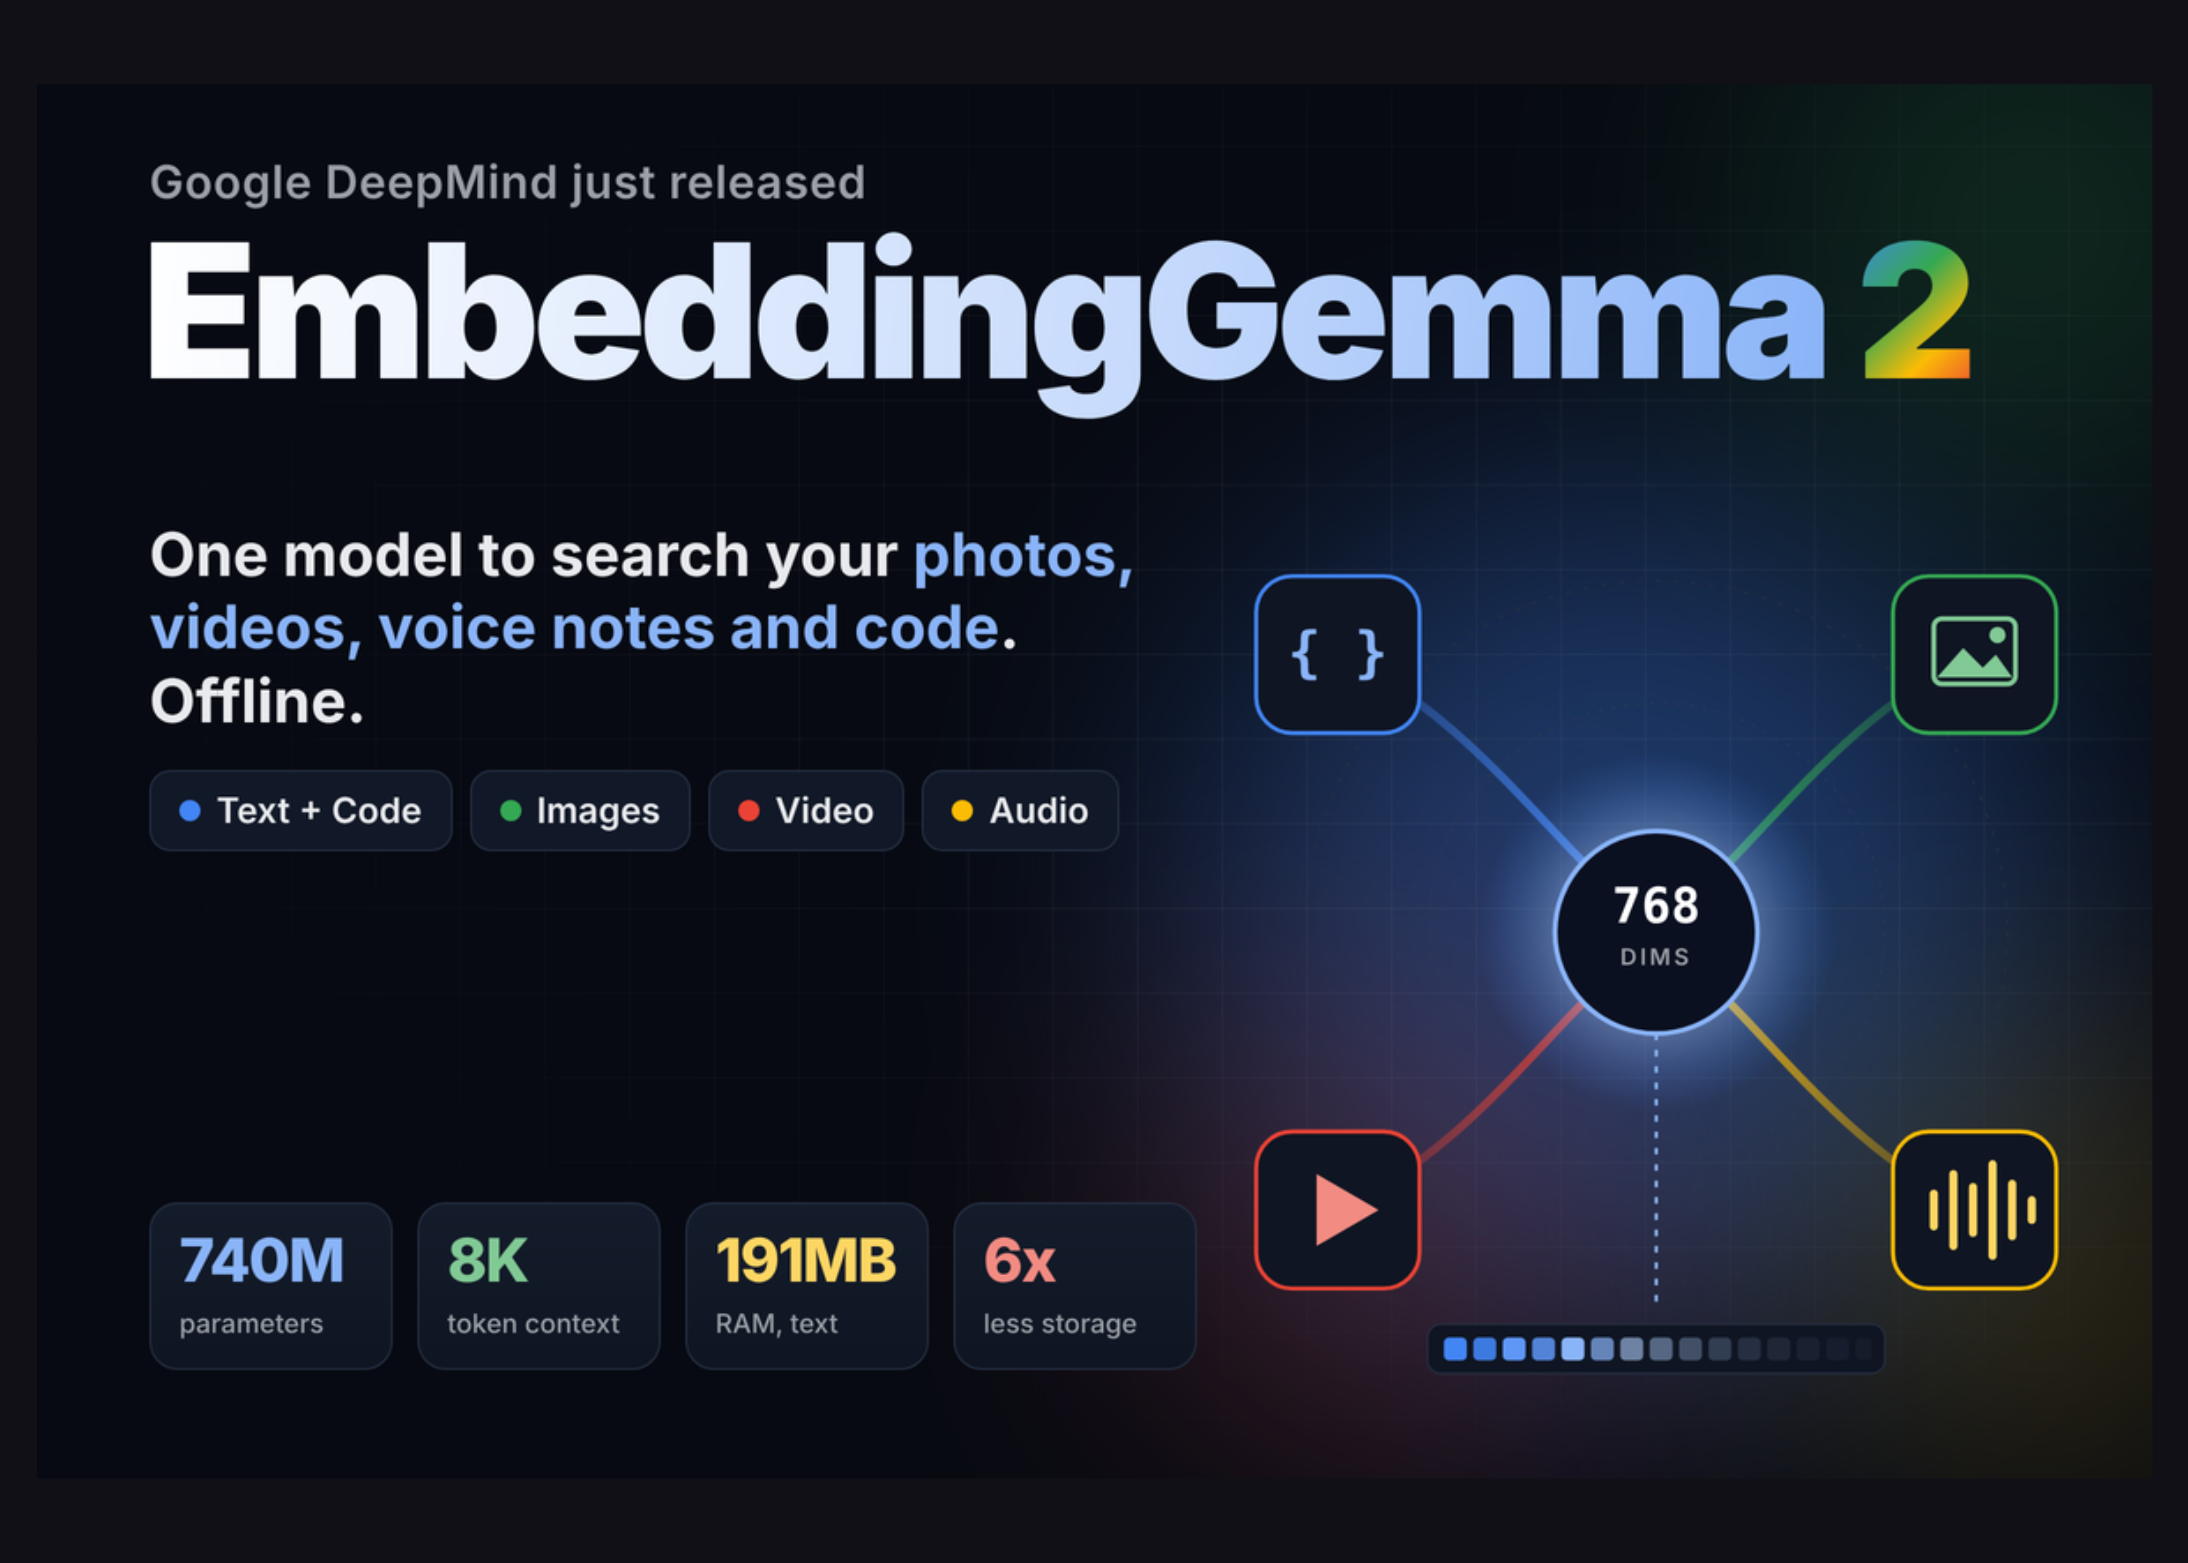
출처: MarkTechPost 관련 기사 (https://www.marktechpost.com/2026/10/06/google-deepmind-releases-embeddinggemma-2-a-740m-open-multimodal-embedding-model-built-on-gemma-4/) — 원본 이미지 링크(복제 저장 아님)
요약
구글의 멀티모달 임베딩 모델 EmbeddingGemma 2(모델 브리핑 2번 참고)가 출시 당일(day-0) 부터 주요 로컬·서빙 엔진에서 돌아갑니다. Ollama 라이브러리에 embeddinggemma-2 가 올라왔고, 태그는 텍스트 전용 270m(약 378MB)부터 비전 440m, 오디오 570m, 전체 740m(약 1.3GB)까지 나뉩니다. ollama pull embeddinggemma-2:740m 후 로컬 /api/embed 엔드포인트로 바로 벡터를 뽑을 수 있습니다.
MarkTechPost에 따르면 이 밖에도 sentence-transformers(v6.1.0+), Transformers, vLLM, SGLang, MLX(애플 실리콘용 머신러닝 프레임워크), llama.cpp(GGUF 형식), LM Studio, LiteRT, MediaPipe를 지원하고, 벡터 저장은 Qdrant, 미세조정은 Unsloth가 맡습니다. 양자화 인식 학습(QAT, 처음부터 저정밀도로 줄일 것을 고려해 학습) 으로 INT4·INT8 가중치를 제공해, 텍스트 구성은 RAM 약 191MB, 전체는 약 567MB면 됩니다. 안드로이드 ML Kit(NPU 가속) 지원은 몇 주 내 예정입니다.
시사점: 임베딩까지 로컬 엔진 하나로 처리할 수 있어, 클라우드 없이 돌아가는 로컬 RAG 파이프라인 구성이 더 쉬워졌습니다.
2. Phoronix: AMD GPU에서 llama.cpp — Vulkan이 처리량, ROCm이 첫 토큰 지연에서 우세
- 원문: https://www.phoronix.com/review/lemonade-vulkan-rocm
- 분야: 엔진 · 성능 벤치마크
- 날짜: 2026-10-05
미디어
출처: 원문 페이지 (Phoronix) — 원본 이미지 링크(복제 저장 아님)
요약
리눅스 하드웨어 매체 Phoronix가 AMD의 로컬 AI 서버 Lemonade 2026.39.1(내부적으로 llama.cpp b10825 사용)로 llama.cpp의 두 GPU 백엔드, Vulkan(범용 그래픽·연산 API) 과 ROCm(AMD의 GPU 연산 플랫폼, 엔비디아 CUDA에 대응) 을 비교했습니다. 시스템은 Radeon AI PRO R9700을 단 System76 Thelio Major 워크스테이션과, Ryzen AI Max+ 395(Strix Halo)를 쓴 Framework Desktop 두 대입니다.
결과는 두 시스템 모두 Vulkan이 토큰 처리량(tokens/s, 초당 생성 토큰 수) 에서 대부분 앞섰고, ROCm은 TTFT(Time To First Token, 첫 토큰이 나오기까지 걸리는 시간) 가 일관되게 더 짧았습니다(때로는 상당히). ROCm이 처리량에서도 이긴 건 Qwen3-Coder-Next-GGUF 한 경우뿐이었습니다. 약 1년 전 RDNA4 비교 때와 비슷하게 Vulkan 강세가 이어진 셈입니다.
시사점: AMD GPU로 로컬 LLM을 돌릴 때, 긴 답변 생성 속도가 중요하면 Vulkan, 대화형 응답 체감(첫 반응 속도)이 중요하면 ROCm을 고려할 만합니다.
3. llama.cpp 10/6 빌드(b11435~b11457) — RPC 텐서 분할, 신규 모델 지원 등
- 원문: https://github.com/ggml-org/llama.cpp/releases
- 분야: 엔진 · 릴리스
- 날짜: 2026-10-06 (UTC 기준 빌드 시각)
미디어
출처: GitHub 자동 생성 소셜 카드 — 원본 이미지 링크(복제 저장 아님)
요약
전날 v0.6.0 버전 표기 이후에도 llama.cpp는 하루 사이 20여 개 빌드를 쏟아냈습니다. 눈에 띄는 변경은 다음과 같습니다(릴리스 노트 기준).
- RPC
-sm tensor추가 (b11450): 여러 기기를 네트워크로 묶어 추론하는 RPC 백엔드(원격 프로시저 호출, 다른 컴퓨터의 연산 자원을 빌려 쓰는 방식) 에서 텐서 단위 분할(split mode tensor, 레이어가 아니라 행렬 자체를 나눠 여러 기기가 동시에 계산) 을 지원. - 신규 모델 지원: K2 Horizon dense·MoVA(b11454), pplx-decider(b11447), PLaMo-3 토크나이저 사전 분할(b11455).
- 백엔드 개선·수정: CUDA XIELU 활성함수 BF16 지원(b11457), Metal 양자화 플래시 어텐션(flash attention, 메모리를 아끼며 어텐션을 빠르게 계산하는 기법) 의 과도한 스레드그룹 메모리 수정(b11446), OpenCL Adreno GEMM 범위 밖 읽기(OOB read) 수정(b11451), 공유 시퀀스에서 k-pool 데이터 경쟁(data race) 수정(b11435).
시사점: 여러 대의 PC·GPU를 엮어 큰 모델을 돌리는 분산 로컬 추론 쪽 기능이 강화되는 중입니다. 프로덕션 사용 시에는 롤링 빌드 대신 안정 태그 기준으로 업데이트하는 게 안전합니다.