모델 브리핑 — 2026-10-13 (화, KST 아침)
10월 13일(화) 아침 브리핑으로 전달된 신규 AI 모델 발표 요약 아카이브입니다. 성능 수치는 회사 발표 또는 명시한 제3자 벤치마크이며, 기사 전문이 아닙니다. 각 항목의 논조·다른 시각은 같은 주제의 다른 매체·평가를 찾아 출처와 함께 덧붙인 것입니다.
1. Meta, Muse Wonder·Muse Wonder Full 공개 — 에이전트용 프론티어 모델; Full은 Muse Code 구독 전용
- 원문: https://about.fb.com/news/2026/10/introducing-muse-wonder-models/
- 분야: 모델 · Meta
- 날짜: 2026-10-12
- 심층 리서치: Meta Muse Wonder, ‘프론티어 복귀’는 진짜지만 가장 센 모델은 아직 손에 안 잡힌다
미디어
출처: 원문 페이지 (Meta / about.fb.com) — 원본 이미지 링크(복제 저장 아님)
요약
Meta가 12일 Muse Wonder와 Muse Wonder Full을 공개했습니다. Muse Spark 이후 스케일링 사다리의 다음 단으로, 개인·업무용 에이전트(목표를 잡고 앱·도구를 넘나들며 일을 이어 가는 AI) 작업에 맞춰 설계했다고 합니다. 학습은 기가와트급 Prometheus 데이터센터에서 이뤄졌고, Active Memory(대화·맥락을 넘어 필요한 정보를 다시 꺼내 씀)와 Active Focus(막혀도 다른 방법을 시도하고, 중요한 조치는 확인을 구함)를 전면에 내세웠습니다. 입력은 텍스트·이미지·오디오·비디오, 출력은 텍스트, 컨텍스트 창은 약 100만 토큰입니다.
가용 범위가 갈립니다. Muse Wonder는 오늘부터 Meta Model API와 Muse Code에서 쓸 수 있고, 곧 Muse 제품에도 구독자부터 들어간다고 했습니다. Wonder Full은 더 강한 쪽이며 현재 Muse Code 유료 구독에서만 제공됩니다(VentureBeat 기준 Power Usage 월 50달러·Maximum 월 200달러대). 가중치(weights)는 공개 다운로드되지 않는 프로프라이어터리 모델입니다. API 정가(회사·매체 정리)는 Wonder 기준 입력 100만 토큰당 4달러, 출력 20달러, 캐시 입력 0.20달러로 Claude Opus 5.5와 같은 구간에 맞춰졌습니다.
독립 벤치마크 기관 Artificial Analysis는 Intelligence Index v4.3에서 Wonder Full 56, Wonder 52(최대 추론 노력)를 줬고, 직전 Muse Spark 1.3(max) 48 대비 각각 +8·+4라고 했습니다. Full은 Claude Sonnet 5.5(56)와 동률, Claude Opus 5.5(58)보다는 아래입니다. Meta 모델 카드·VentureBeat가 정리한 표에서는 SWE-Marathon·일부 법률·자동화 벤치에서 Full이 앞서는 항목이 있는 반면, Terminal-Bench·HealthBench 등에서는 Opus/GPT-6 Astra에 뒤지는 항목도 있습니다. 지식(AA-Omniscience)은 상대적 약점이나 환각률은 낮다고 Artificial Analysis는 적었습니다.
논조·다른 시각
- 기사 논조: 긍정(회사 발표문) — ‘가장 강력한 모델’, 프론티어·안전·개인 슈퍼인텔리전스 서사가 중심입니다.
- 논조 점검: Meta 비교표는 내부 평가·벤더 제공·제3자 점수가 섞여 있고, 코딩 도구·프롬프트·추론 설정이 모델마다 다를 수 있다고 VentureBeat가 지적합니다. Wonder Full은 공개 API가 아니라 Muse Code 경로로 측정된 점이 있어 ‘API 모델 대 API 모델’ 비교로 읽으면 안 됩니다. 가격은 Spark 대비 크게 올랐고, 작업당 비용은 토큰 단가×사용량입니다.
- 다른 시각:
- Artificial Analysis: Spark 대비 지능 지수가 실질적으로 뛰었고 에이전트·코딩 쪽 상승이 크다고 평가하면서도, Wonder(max) 작업당 비용 약 4.52달러로 비슷한 지능대 모델 중 비싼 편이며 지식 점수는 약하다고 선을 그었습니다 (Artificial Analysis).
- VentureBeat: Full이 API에 없고 셀프호스팅도 불가하며, Muse Code 기본 Contributor 모드(데이터 학습 활용)와 Standard/제로 Retention 차이를 기업 구매 리스크로 강조했습니다 (VentureBeat).
- 예상 쟁점: Full의 API 개방 시기, 그리고 벤치마크 상승이 실제 업무 에이전트 신뢰도로 이어지는지입니다.
시사점: Meta가 다시 ‘다운로드 Llama’가 아니라 호스티드 프론티어 API 경쟁으로 무게를 옮긴 발표입니다. 쓸 때는 Wonder API vs Full(Muse Code만) vs 데이터 모드를 먼저 가르고 보는 게 좋습니다.
2. Continuum AI, 사이버보안 추론 모델 OrcaCyber Zero 1.5 발표 — 회사 기준 CVE-Bench 95.8%·Cybench 100%
- 원문: https://www.prnewswire.com/news-releases/continuum-ai-introduces-orcacyber-zero-1-5–a-frontier-cybersecurity-reasoning-model-302905663.html
- 분야: 모델 · 보안 특화
- 날짜: 2026-10-12
미디어
출처: 원문 페이지 (PR Newswire / Continuum AI) — 원본 이미지 링크(복제 저장 아님)
요약
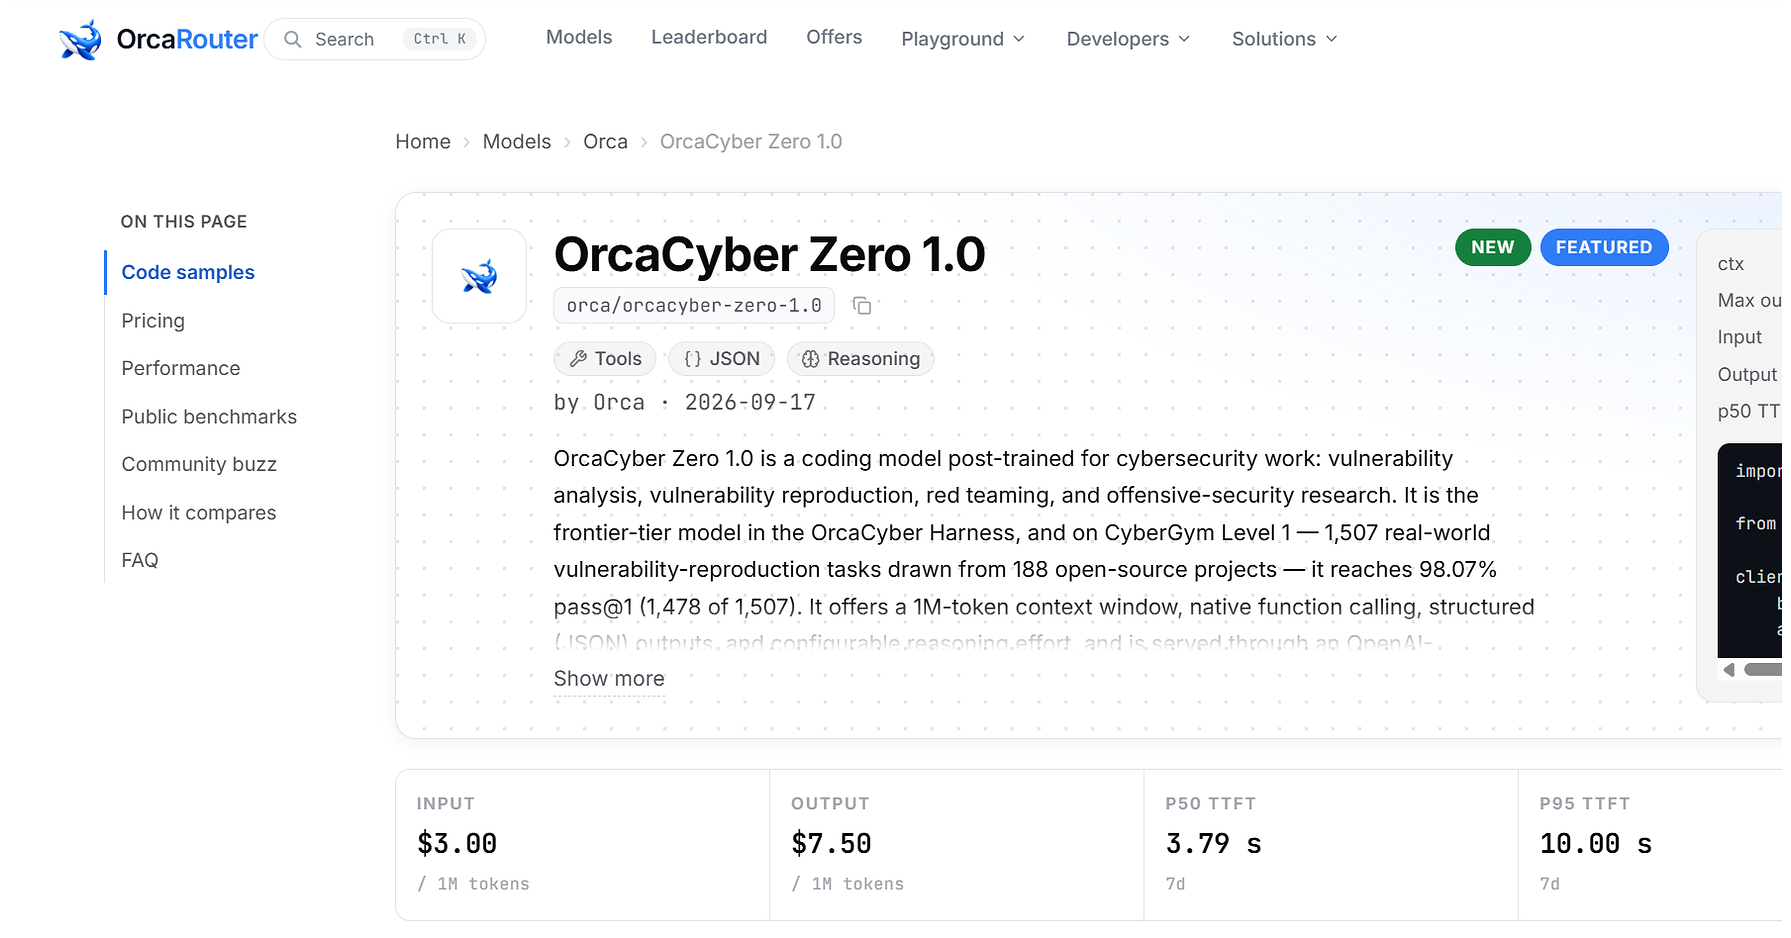
Continuum AI가 12일 사이버보안 특화 추론 모델 OrcaCyber Zero 1.5를 발표했습니다. 100만 토큰 컨텍스트, 네이티브 도구 호출, 확장 추론을 내세워 대규모 코드베이스·보안 로그·긴 조사 이력을 한 세션에서 다루게 했다고 합니다. 회사 발표 기준 벤치마크는 CVE-Bench 95.8%(평가 가능 24과제 중 23), Cybench 100%(39/39, unrestricted), HumanEval+ 93.9%입니다. 전작 Zero 1.0은 CyberGym에서 자율 하네스 pass@1 98% 이상을 냈고 글로벌 상위권이었다고 자사 집계를 인용했습니다.
제품은 Orca Router AI 게이트웨이에서 탐색할 수 있다고 안내했고, 다음 주에는 로컬 배포용으로 더 강한 오픈웨이트 사이버보안 모델도 내놓겠다고 예고했습니다. 대상 고객으로는 보안 연구자·엔터프라이즈·정부·블록체인·보안 업체를 꼽았습니다.
논조·다른 시각
- 기사 논조: 긍정 — PR Newswire 보도자료 특성상 자사 벤치·로드맵 홍보가 전부입니다.
- 논조 점검: 수치·순위·고객 사례가 모두 회사 측 주장입니다. 독립 재현·제3자 리더보드 링크·모델 크기·가격·라이선스가 본문에 거의 없습니다. ‘프론티어’ 표현은 마케팅 수사에 가깝습니다. 오픈웨이트 예고는 일정만 있고 세부 스펙이 없습니다.
- 다른 시각:
- 찾은 반론 없음 (검색 범위: OrcaCyber Zero 1.5 독립 벤치마크·보안 매체 검증 기사 — 12~13일 기준 회사 보도 재전달 위주).
- 예상 쟁점: 공격적 악용(offensive) 가능성과 접근 통제, 그리고 다음 주 오픈웨이트가 실제 가중치 공개인지 제한 라이선스인지입니다.
시사점: 보안 특화 모델 발표가 이어지는 가운데, 회사 벤치를 그대로 믿기보다 자사 코드·로그로 재현해 보는 쪽이 안전합니다. 오픈웨이트 예고가 있으면 그때 라이선스·가드레일을 다시 보면 됩니다.