IT 브리핑 — 2026-10-13 (화, KST 아침)
10월 13일(화) 아침 브리핑으로 전달된 IT 산업·반도체·인프라 소식 요약 아카이브입니다. 주로 12일(현지)·13일(KST) OCP(Open Compute Project, 빅테크·서버 업체가 데이터센터 하드웨어 표준을 함께 만드는 오픈 프로젝트) 글로벌 서밋과 맞물린 발표를 모았습니다. 기사 전문이 아니라 요약이며, 자세한 내용은 각 원문 링크를 확인하세요. 각 항목의 논조·다른 시각은 같은 주제의 다른 매체·전문가·커뮤니티 반응을 찾아 출처와 함께 덧붙인 것입니다.
1. 삼성전자, OCP서 AI 메모리 ‘속도·확장성·영속성’ 3축 전략 — HBM5·CXL·SSD 전시, AMD와 공동 시연
- 원문: https://www.yna.co.kr/view/AKR20261013015800091
- 분야: IT · 반도체/국내 기업
- 날짜: 2026-10-13
요약
삼성전자가 12일(현지시간, 한국 시각 13일) 미국 캘리포니아주 새너제이에서 열린 OCP(Open Compute Project, 빅테크·서버 업체가 데이터센터 하드웨어 표준을 함께 만드는 오픈 프로젝트) 글로벌 서밋에서 속도와 확장성, 영속성(오래 보관)에 초점을 맞춘 새 메모리 전략을 공개했습니다. 심호준 삼성전자 DS부문 메모리사업부 AE팀 상무가 발표를 맡았고, 연합뉴스·매일경제 등이 보도했습니다.
속도 축에는 차세대 HBM(High Bandwidth Memory, D램을 수직으로 쌓아 데이터 통로를 크게 넓힌 AI 가속기용 메모리)5, 맞춤형 HBM, 연산칩 위에 메모리를 적층하는 zHBM, 간단한 연산을 메모리 안에서 수행하는 PIM(Processing-In-Memory, 메모리 안에서 일부 계산을 직접 처리하는 기술) 이 들어갑니다. 확장성 축에서는 CXL(Compute Express Link, AI 가속기와 메모리를 효율적으로 이어 주는 개방형 연결 규격) 과 이를 쓰는 메모리 모듈 CMM-D(CXL Memory Module-DRAM, CXL로 붙이는 D램 모듈) 로 서버가 쓸 수 있는 메모리 용량 한계를 넘기겠다고 했습니다. 영속성 축은 차세대 기업용 SSD(Solid State Drive, 반도체 기반 저장 장치) 로 대규모 AI 데이터를 담는 쪽입니다. 전시 공간에는 HBM5 모형(Mockup)과 웨이퍼 등도 올렸습니다.
같은 행사에서 삼성전자는 AMD와 CXL 기반 메모리 확장(여러 서버가 메모리를 공동 창고처럼 나눠 쓰는 방식)을 공동 시연할 예정이라고 밝혔습니다. 리사 수 AMD CEO가 최근 방한해 삼성전자를 방문한 직후라, 3월 업무협약이 실제 시스템 검증으로 이어지고 있다는 해석이 나옵니다(매일경제). 기사는 카운터포인트·트렌드포스를 인용해 삼성전자가 올해 2분기 글로벌 D램 점유율 39%, 낸드 29.3%로 각각 1위이며, 옴디아 기준으로 올해 연간 D램 생산능력(300㎜ 웨이퍼)도 SK하이닉스·마이크론을 앞선다고 덧붙였습니다.
논조·다른 시각
- 기사 논조: 긍정 — 3대 축 전략과 AMD 공동 시연, 점유율·생산능력 수치를 나란히 배치해 ‘AI 추론 메모리 풀스택’ 쪽에 무게를 둡니다.
- 논조 점검: HBM5는 모형 전시 단계이고 양산·공급 일정·고객사 이름은 없습니다. 점유율·생산능력은 시장조사업체 수치이며, ‘전략 공개’가 곧바로 수주나 점유율 확대로 이어진다는 근거는 기사에 없습니다. 회사 발표·행사 취재 중심이라 경쟁사(SK하이닉스 HBM4E·HBF 등) 일정과 직접 비교한 독립 검증은 약합니다.
- 다른 시각:
- 국내 경쟁 구도(뉴시스): 같은 주 코엑스 SEDEX(반도체대전) 2026(14~16일)에서 SK하이닉스는 HBM4E와 HBF(High Bandwidth Flash, 낸드를 쌓아 HBM과 SSD 사이를 보완하는 저장 기술) 를 앞세운다고 보도됐습니다. HBM 한 제품이 아니라 속도(HBM4E)와 용량(HBF)을 나눠 가져가려는 구도입니다 (뉴시스).
- 방열·패키징(글로벌이코노믹, 트렌드포스 인용): HBM4E 세대에서는 인터포저 대형화에 따른 열 제어가 분수령이라며, 삼성은 하이브리드 구리 본딩·히트 패스 블록, SK하이닉스는 iHBM 냉각 소재로 맞선다고 정리했습니다 (글로벌이코노믹).
- 예상 쟁점: OCP 발표의 ‘3축’이 실제 고객 납품 일정과 어떻게 맞물리는지, CXL 시연이 상용 랙 표준으로 이어질지가 다음 확인 포인트입니다.
시사점: AI 추론이 커질수록 HBM 속도만으로는 부족하고, CXL로 용량을 늘리고 SSD로 영속 저장을 받는 ‘풀스택’ 경쟁이 공식화된 하루였습니다. SEDEX(14일~)와 AMD 시연 결과가 바로 다음 체크포인트입니다.
2. AMD, OCP서 에이전트 AI용 랙 설계 ‘Helion’ 공개 — CPU만으로 최대 3만 2,768코어, 11월 출하 목표
- 원문: https://newsroom.amd.com/news/open-rack-blueprint-scale-agentic-ai/
- 분야: IT · 반도체/서버 인프라
- 날짜: 2026-10-12
미디어
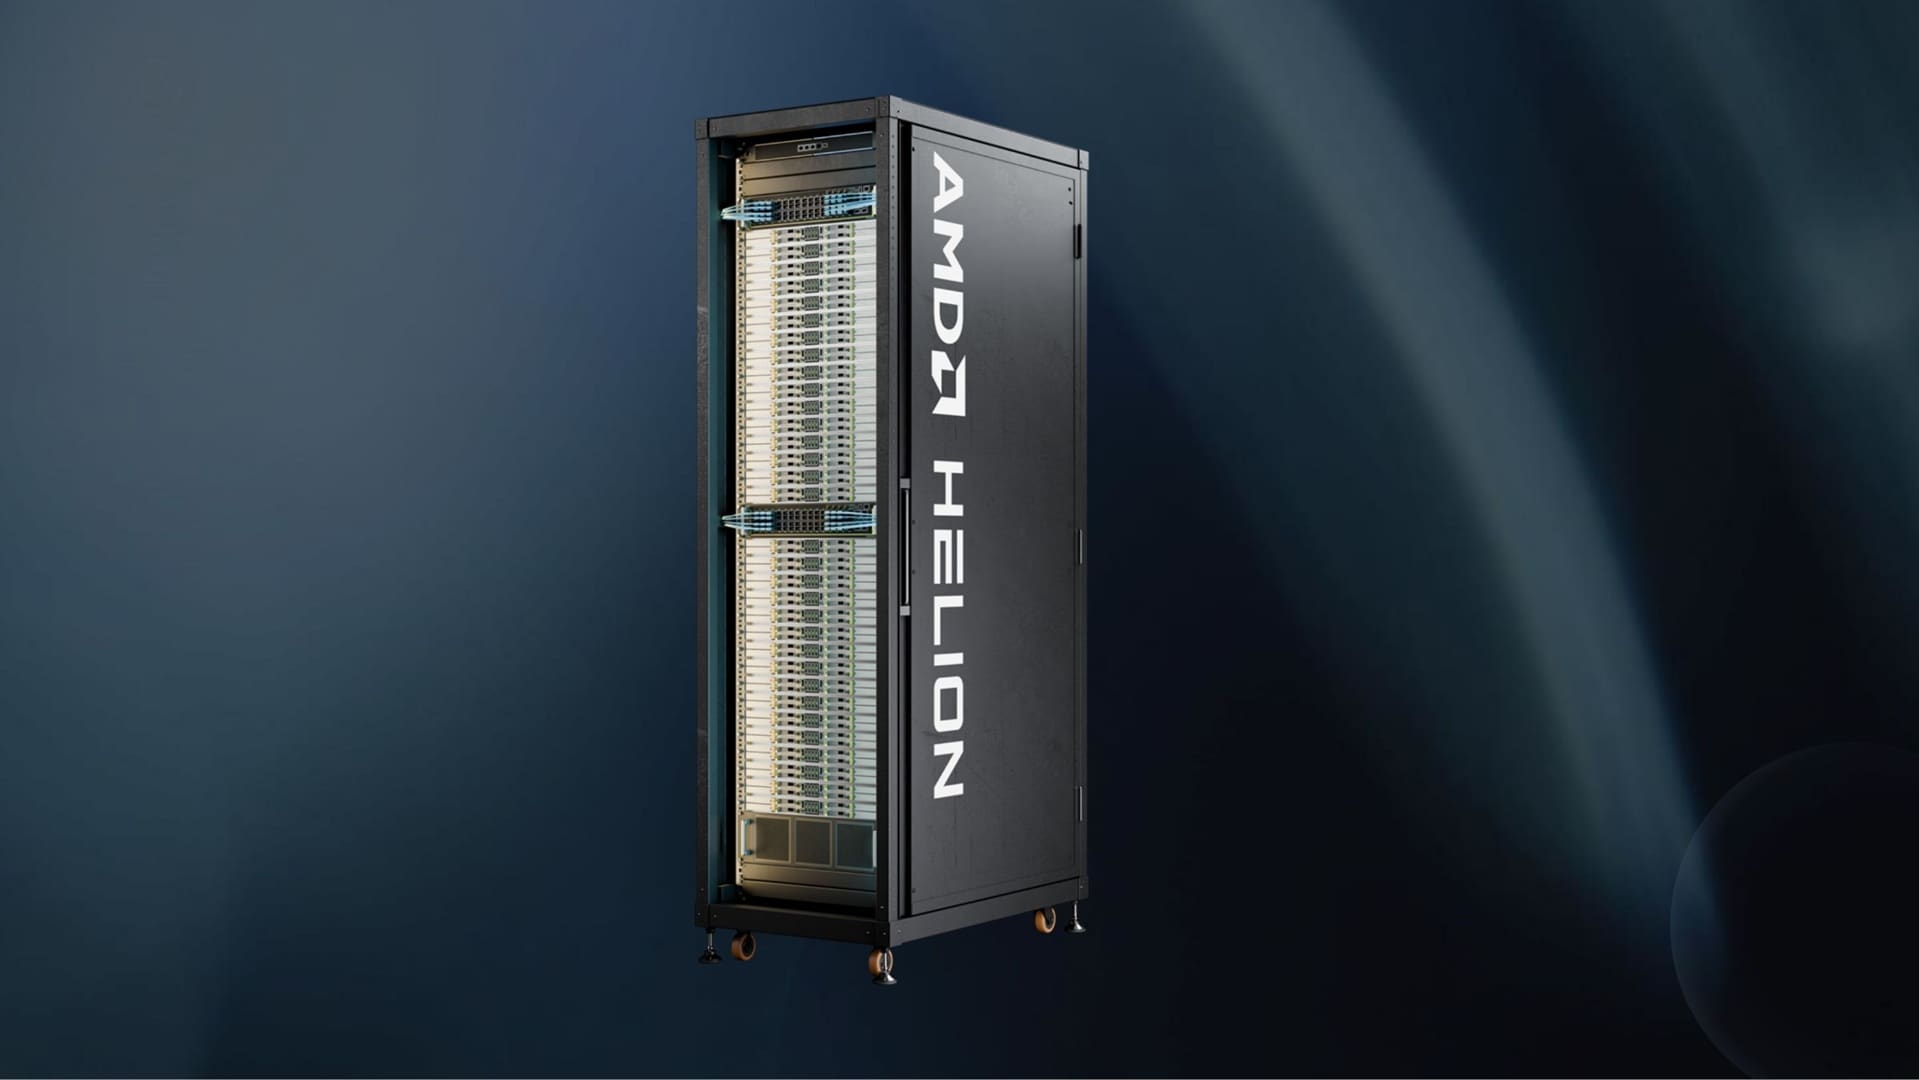
출처: 원문 페이지 (AMD Newsroom) — 원본 이미지 링크(복제 저장 아님)
요약
AMD가 12일 OCP 글로벌 서밋에서 에이전트 AI(Agentic AI, 목표를 잡고 도구를 쓰며 여러 단계 작업을 스스로 이어 가는 AI) 인프라용 오픈 랙 블루프린트 Helion을 공개했습니다. 앞서 내놓은 Helios 랙스케일 솔루션의 개방형 접근을 이어가며, OCP 규격 기반 설계에 AMD 연산(CPU·GPU)을 얹는 형태입니다. 스펙은 OCP에 기여할 계획이고, 파트너와 개발 중인 구성은 2026년 11월 가용을 목표로 합니다.
구성은 크게 두 갈래입니다. 하이퍼스케일용 CPU 전용 랙은 6세대 AMD EPYC(서버용 CPU 브랜드) ‘Venice’ 프로세서로 최대 32,768 CPU 코어를 담을 수 있다고 했고, 에이전트 실행 전용 용량을 두고 모델 추론은 별도 인프라에 붙이는 그림입니다. 기업용 올인원 랙은 EPYC CPU 노드와 Instinct MI350P GPU 노드, 범용 연산을 한 플랫폼에 묶습니다. 공랭·액랭 모두 지원한다고 밝혔고, 에이전트의 모델 호출을 프론티어·오픈소스 모델로 나누어 보내는 토큰 라우터(token router) 도 강조했습니다.
생태계 파트너로는 Cisco, Dell, Hon Hai(폭스콘), HPE, Lenovo, QCT, Supermicro, Wiwynn 등이 지지 발언을 냈습니다. Dan McNamara AMD 수석부사장(컴퓨트·엔터프라이즈 AI)은 “에이전트 AI는 단일 워크로드가 아니라 개인 에이전트·기업 앱·코드 실행·복잡한 워크플로마다 연산 요구가 다르다”며, 전력과 성능·비용을 맞춰 짜는 유연성이 Helion의 핵심이라고 설명했습니다.
논조·다른 시각
- 기사 논조: 긍정 — 회사 보도자료 특성상 유연성·파트너 인용·11월 가용에 무게를 둡니다. 전방 주의문(forward-looking)으로 일정·혜택이 달라질 수 있다고도 밝힙니다.
- 논조 점검: 실제 출하 가격·전력량(와트)·벤치마크·고객 이름은 없습니다. ‘최대 32,768코어’는 구성 상한이며, 모든 고객이 그 밀도에 도달한다는 뜻이 아닙니다. 보도자료 + 파트너 인용 중심이라 독립 성능 검증은 아직 없습니다.
- 다른 시각:
- 업계 매체(DCD): Helion을 Helios의 개방형 접근을 이은 커스터마이즈 가능한 랙스케일로 소개하며, CPU 전용 옵션과 11월 가용·파트너 목록을 확인했습니다. 성능 숫자보다는 ‘구성 선택권’에 초점을 맞춥니다 (Data Center Dynamics).
- 하드웨어 매체(Tom’s Hardware): Zen 6 ‘Venice’ 코어 수와 CPU 전용·올인원 구성, 연내(11월) 출하 계획을 정리하며 에이전트 워크로드가 CPU 실행과 GPU 추론을 나누는 수요를 반영한 설계라고 해석했습니다 (Tom’s Hardware).
- 예상 쟁점: 에이전트 실행을 CPU에 두고 추론을 분리하는 설계가 실제 토큰 지연·전력비에서 NVIDIA 중심 GPU 랙과 어떻게 경쟁할지가 관전 포인트입니다.
시사점: ‘모델 추론 GPU’만으로는 에이전트 시대를 설명하기 어렵다는 신호가 하드웨어 쪽에서도 나왔습니다. 11월 실제 파트너 시스템과 OCP 스펙 기여 여부를 보면 됩니다.
3. 엔비디아, OCP서 Vera Rubin 랙·트레이 설계를 MGX로 공개 기여 — 시스코·구글·메타 등과 AI 팩토리 표준 확장
- 원문: https://blogs.nvidia.com/blog/ocp-global-summit-vera-rubin-scale-ai-factories/
- 분야: IT · 반도체/AI 인프라
- 날짜: 2026-10-12
미디어
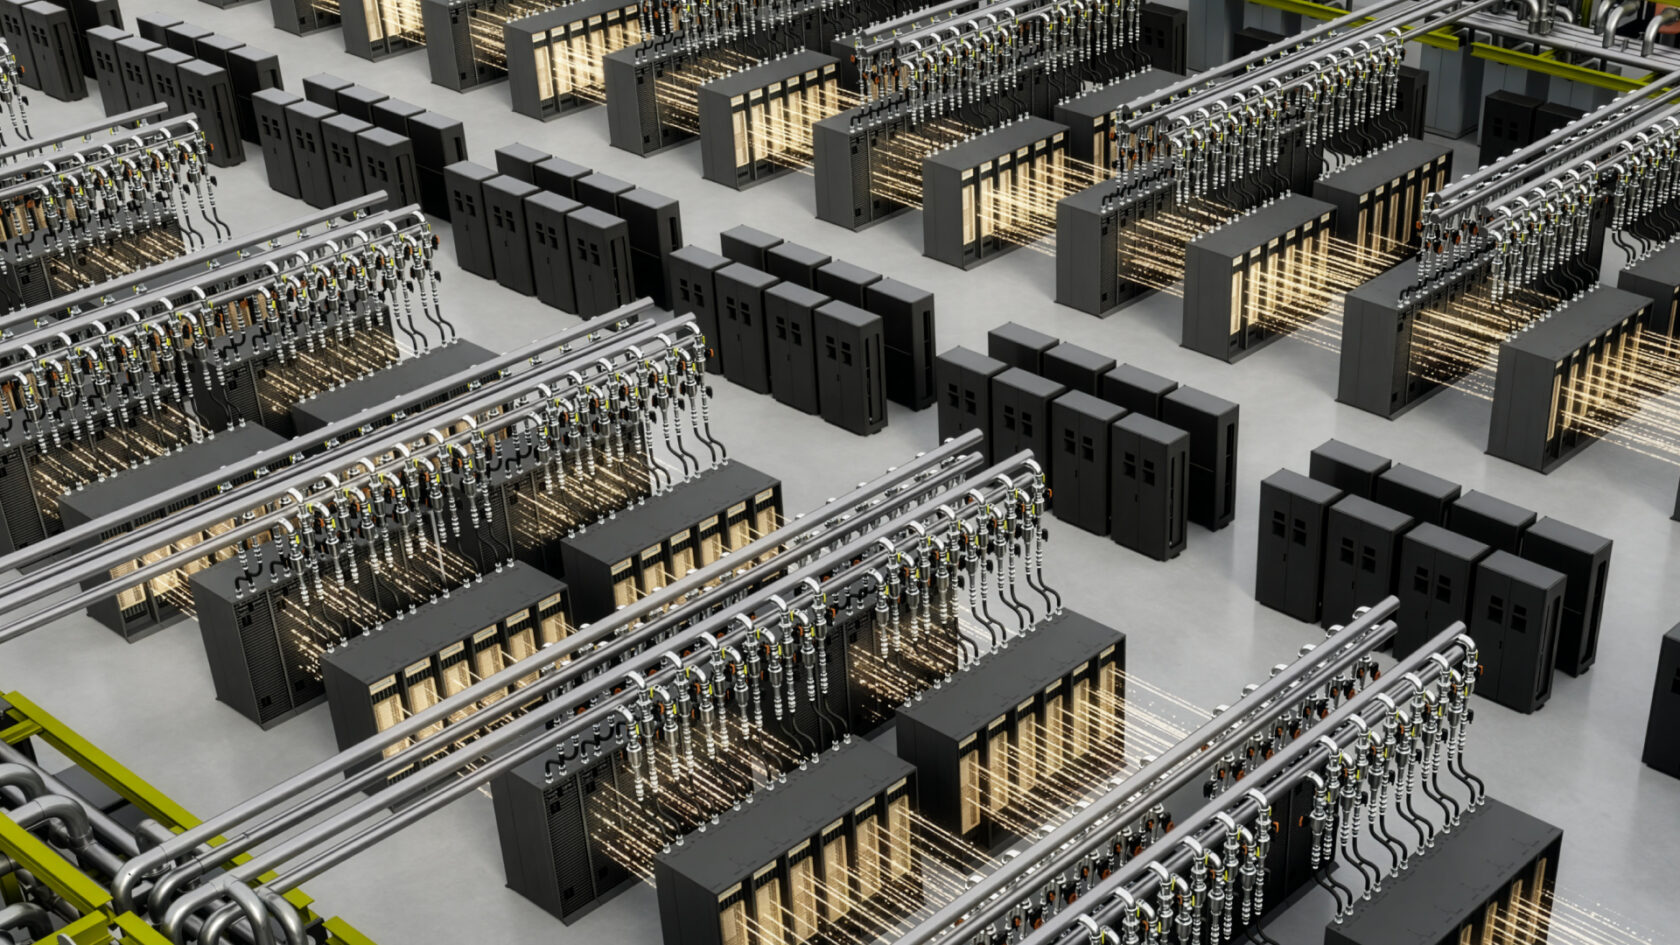
출처: 원문 페이지 (NVIDIA Blog) — 원본 이미지 링크(복제 저장 아님)
요약
엔비디아가 같은 OCP 글로벌 서밋에서 Vera Rubin 랙·컴퓨트 트레이 설계의 핵심을 오픈 MGX 아키텍처를 통해 OCP에 기여한다고 밝혔습니다. 목표는 차세대 AI 팩토리(대규모 AI 학습·추론을 돌리는 데이터센터 설비) 인프라를 시스템 빌더가 공통 기반으로 만들 수 있게 하는 것입니다. Cisco, Google, Meta, Microsoft, Visionbay 등이 Vera Rubin 관련 진전을 함께 언급됐습니다.
블로그에 따르면 하이퍼스케일러와 함께 AI 팩토리 설계 표준·그리드(전력망) 회복력 관련 오픈 표준을 공개했고, DSX AI Factory용 오픈소스 소프트웨어 컴포넌트도 새로 내놓았습니다. 네트워킹 쪽에서는 Meta가 Spectrum-6 102.4T급 스위치를 채택해 더 큰 Vera Rubin AI 팩토리를 짓는다고 했고, 엔비디아·Cisco는 대역 밀도·전력 효율을 높이기 위한 새 광학 플러그형 모듈 폼팩터 USFP 계획을 발표했습니다. 엔비디아·구글은 향후 ConnectX-10 SuperNIC와 BlueField DPU에서 Falcon Transport(혼잡 시에도 이더넷 위에서 데이터를 안정적으로 나르는 전송 규격)를 지원한다고 했습니다.
에이전트·추론 수요가 커지면서 ‘칩 하나’가 아니라 랙·네트워크·전력·냉각을 묶은 공장형 설계 경쟁이 OCP 무대에서 동시에 펼쳐진 하루로 읽힙니다. AMD Helion·삼성 메모리 전략과 같은 날 겹칩니다.
논조·다른 시각
- 기사 논조: 긍정 — 자사 블로그답게 파트너 이름과 오픈 기여·표준화를 앞세워 생태계 리더십을 강조합니다.
- 논조 점검: 구체적인 성능 수치·가격·가용 일정은 항목마다 다르고, 일부는 ‘계획·지원 예정’입니다. 파트너 인용과 자사 발표가 주를 이뤄 독립 검증이나 경쟁 설계(AMD Helion 등)와의 직접 비교는 없습니다.
- 다른 시각:
- 같은 날 경쟁 구도(AMD·DCD): AMD는 CPU 중심 Helion 랙을 내놓으며 에이전트 실행과 추론을 나누는 구성을 강조했습니다. 엔비디아의 GPU·네트워킹 중심 AI 팩토리 서사와 맞서는 ‘CPU 실행 랙’ 서사가 같은 OCP 무대에 올라온 셈입니다 (AMD 보도, DCD).
- 찾은 반론 없음 (검색 범위: OCP 2026 Vera Rubin 관련 독립 비판 기사 — 당일 보도는 대체로 발표 요약 위주).
- 예상 쟁점: 오픈 기여의 실제 라이선스·구현 완성도와, Spectrum-6·Falcon·USFP가 상용 랙에 언제 들어가는지가 관건입니다.
시사점: OCP 2026은 ‘칩 스펙’보다 ‘랙·전력·네트워크 표준’ 전쟁이 전면화한 자리였습니다. 삼성·AMD·엔비디아 발표를 같이 보면 AI 인프라 병목이 메모리·CPU 실행·패브릭으로 나뉘어 보입니다.